Anthropic 发布 Claude Opus 5:性能接近 Fable 5,价格仅为其一半
Anthropic 发布 Claude Opus 5:性能接近 Fable 5,价格仅为其一半
CharoAnthropic 正式推出 Claude Opus 5:性能直逼旗舰 Fable 5,加量不加价
Anthropic 今日正式发布全新一代模型 Claude Opus 5。该模型在智能水平上已极度接近其旗舰模型 Claude Fable 5,但使用成本仅为 Fable 5 的一半,且订阅定价与上一代 Opus 4.8 完全持平,实现了真正的“加量不加价”。
即日起,Opus 5 已全面上线:
- Claude Max:成为系统默认主控模型
- Claude Pro:成为当前可用的最强模型
核心基准测试表现
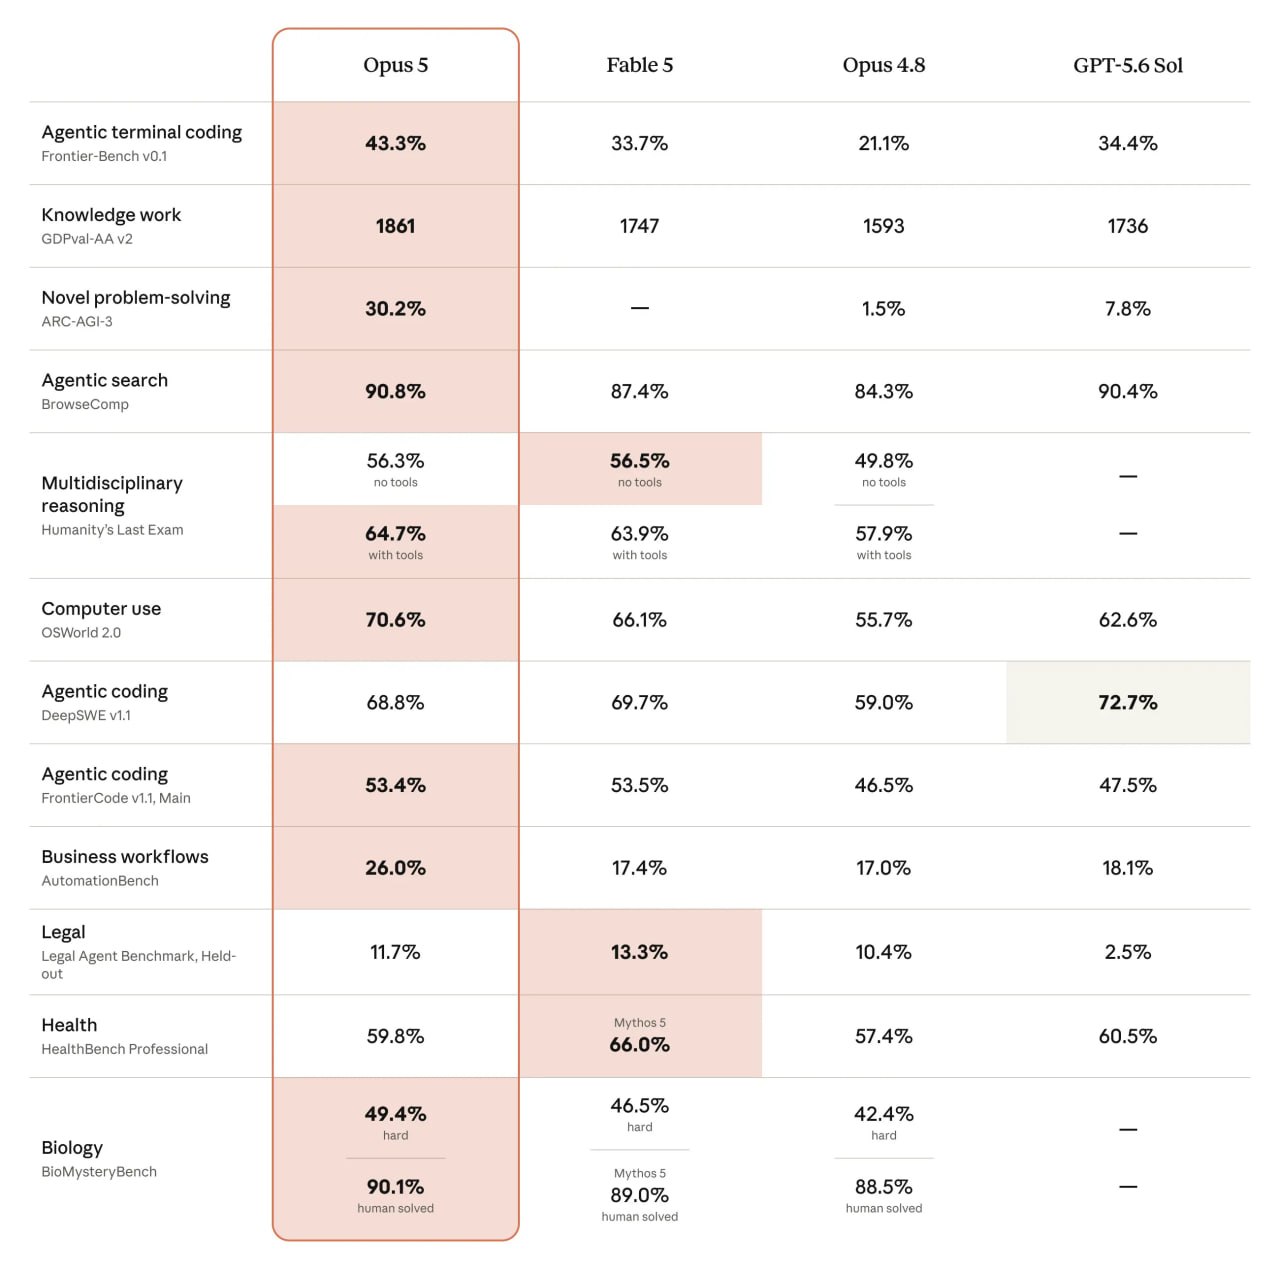
在多项行业权威及前沿基准测试中,Opus 5 均刷新了历史纪录,尤其在复杂编码与高级知识工作任务上展现出远超 Opus 4.8 的跨越式提升:
| 测试集 (Benchmark) | 领域 / 场景 | 表现亮点 |
|---|---|---|
| Frontier-Bench | 前沿综合智能 | 刷新最高分纪录 |
| ARC-AGI 3 | 抽象推理与通用智能 | 创下全新 SOTA 成绩 |
| Zapier AutomationBench | 自动化工作流与 Agent 能力 | 流程自动化与工具调用能力远超上一代 |
| Cybersecurity | 网络安全防护与攻防 | 表现强劲,但目前仍次于 Mythos 5 |
🌚 反直觉的小插曲:官网初始公布的 Agentic Coding(自主编程)胜率一度出现了 $53.4% > 53.5%$ 的神仙数学题,不过官方已通过 OTA 紧急修复了前端数据展示。
升级亮点总结
- 极致性价比:以 Opus 4.8 的价格,获得了接近 Fable 5 的顶尖推理能力。
- 生产力重塑:长文本逻辑、复杂代码库重构及 Agent 自动化执行能力大幅提升。
- 定位清晰:在综合知识与编码领域逼近极值,同时在特定高危领域(如网络安全)保持与 Mythos 5 的差异化定位。
🤖 Anthropic 发布 Claude Opus 5:性能接近 Fable 5,价格仅为其一半
Anthropic 正式推出 Claude Opus 5。该模型在智能水平上接近旗舰 Claude Fable 5,但使用成本仅为后者的一半,定价与上一代 Opus 4.8 持平。Opus 5 即日起成为 Claude Max 的默认模型,也是 Claude Pro 上最强的模型。
在 Frontier-Bench、ARC-AGI 3、Zapier AutomationBench 等多项基准测试中,Opus 5 均刷新纪录,编码和知识工作任务表现远超 Opus 4.8。在网络安全任务上,该模型仍落后于 Mythos 5。
AnthropicAI (https://www.anthropic.com/news/claude-opus-5)
ps: Agentic coding 处 53.4% > 53.5% 🌚(官网已 OTA)
评论
匿名评论隐私政策